
GetAnalyst - Навыки • Системный анализ • Бизнес-анализ
tg22 тыс. подписчиков
Открыть пост ↗
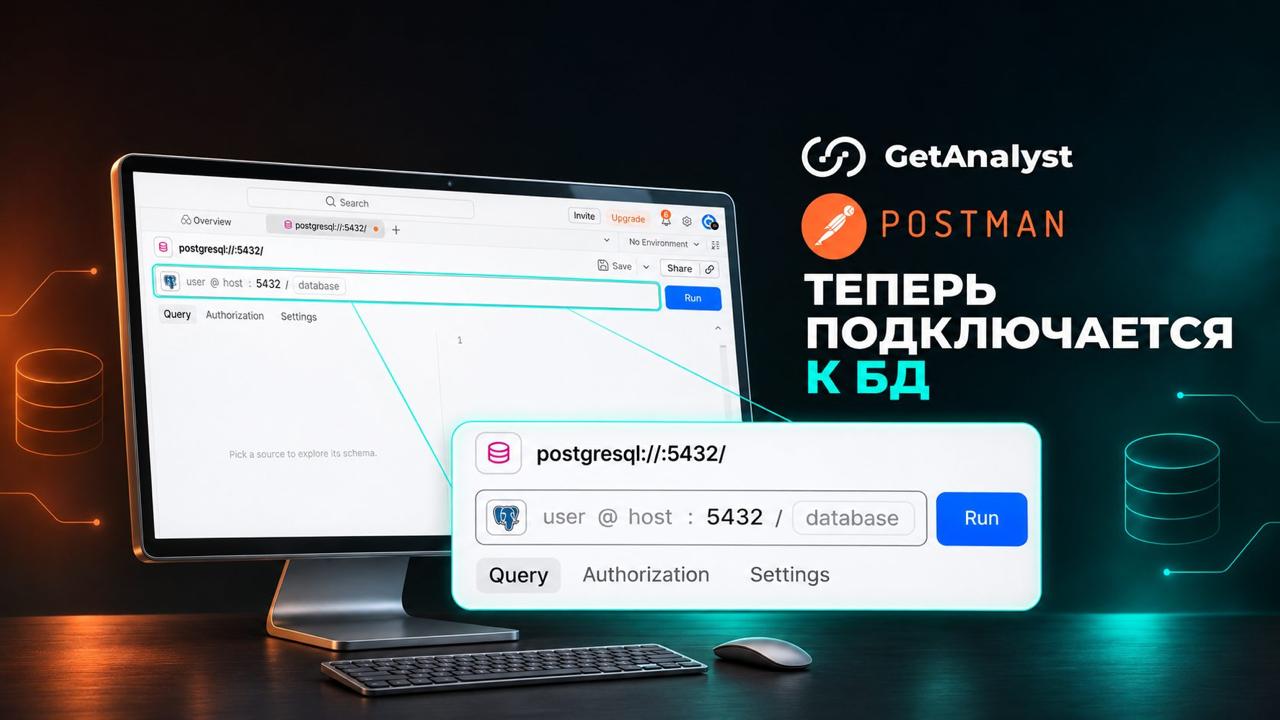
🟧 Postman теперь подключается к PostgreSQL. Зачем они конкурируют с DBeaver? 🟧
Начну сразу с того, что Postman не пытается заменить DBeaver.
Postman решает другую наболевшую задачу:
связывает в одном месте API-запрос, тестовые данные и проверку того, что действительно сохранилось в БД.
В Postman v12 появились два связанных механизма.
✅️️️️️️️ Запросы к данным - Data Requests
Встроенный клиент для работы с данными позволяет прямо из Postman:
▫️ подключиться к PostgreSQL или MySQL
▫️ посмотреть таблицы и столбцы
▫️ написать и выполнить SQL-запрос
▫️ найти и отсортировать результат
▫️ сохранить запрос в коллекцию
▫️ включить режим Read-only, чтобы запретить изменение данных и структуры БД
То есть отправили запрос к API через Postman, и здесь же проверили, что произошло с данными.
✅️️️️️️️ Наборы тестовых данных - Postman Datasets
БД можно подключить как источник данных и использовать её в:
▫️ Collection Runner
▫️ автотестах и скриптах
▫️ динамических Mock Server
▫️ нагрузочных тестах
▫️ Postman CLI и CI/CD-конвейерах
Большинство этих возможностей уже хорошо знакомо выпускникам нашей программы Дизайн REST API: мы работаем с коллекциями, переменными, скриптами, Mock Server.
Теперь к этому процессу можно подключить ещё и живые данные из PostgreSQL, MySQL или SQL Server.
📌️️ Как может выглядеть такой конвейер?
Допустим, мы тестируем создание заказа в интернет-магазине.
1️⃣ Postman получает из тестовой БД пользователей и товары, подходящие для сценария.
2️⃣ Collection Runner опираясь на реальные данные из БД по пользователям и товарам запускает:
POST /orders
3️⃣ Скрипт проверяет:
▫️ код 201 Created
▫️ структуру JSON
▫️ наличие orderId
▫️ правильность суммы и статуса
4️⃣ Затем Postman обращается к подключённой БД и проверяет:
5️⃣ Сравниваем ответ API с тем, что реально сохранилось в таблице.
6️⃣ Эту же коллекцию можно автоматически запускать через Postman CLI в CI/CD после обновления приложения.
И вот здесь уже понятен смысл обновления.
Раньше тестовые данные часто жили в CSV-файлах, переменных окружения и локальных скриптах. На компьютере одного человека всё работало, а в автоматическом запуске внезапно ломалось, потому что файл забыли обновить или передать.
Теперь команда может использовать единый источник данных и воспроизводить одинаковые сценарии локально, в Collection Runner и в автоматическом конвейере.
🦫 DBeaver при этом всё ещё нужен.
В нём удобнее полноценно исследовать БД, проектировать структуру, работать с индексами, ограничениями, сложными запросами и администрированием.
🟧 Postman нужен для другого:
1. вызвали API
2. проверили ответ
3. проверили данные
4. запустили сценарий тестирования автоматически
👉 Чем это полезно системному аналитику?
Можно быстрее:
▫️ проверить маппинг полей API в таблицы БД
▫️ убедиться, что POST, PUT или PATCH действительно изменили данные
▫️ проверить статусы, связи и бизнес-ограничения
▫️ сравнить ответ API с фактическим состоянием БД
▫️ собрать воспроизводимый сценарий для разработчика или тестировщика
▫️ понять, где ошибка: в контракте API, бизнес-логике или сохранении данных
Особенно полезно, когда API вернул 200 OK, а в базе почему-то оказалось совсем не то, что ожидалось 😅
Подключаться лучше к тестовой БД, использовать отдельного пользователя с минимальными правами, включать Read-only, а пароли хранить в Postman Vault.
Получается, Postman постепенно превращается из клиента для HTTP-запросов в среду для проверки всего сценария работы бэкенда.
💡️️️️️️ А ваша команда использует Postman и знает про это обновление?
Будьте первопроходцем, просвятите ваших QA и backend-разработчиков 😉
#ResApiGa
Tg | ВК | Max
Начну сразу с того, что Postman не пытается заменить DBeaver.
Postman решает другую наболевшую задачу:
связывает в одном месте API-запрос, тестовые данные и проверку того, что действительно сохранилось в БД.
В Postman v12 появились два связанных механизма.
✅️️️️️️️ Запросы к данным - Data Requests
Встроенный клиент для работы с данными позволяет прямо из Postman:
▫️ подключиться к PostgreSQL или MySQL
▫️ посмотреть таблицы и столбцы
▫️ написать и выполнить SQL-запрос
▫️ найти и отсортировать результат
▫️ сохранить запрос в коллекцию
▫️ включить режим Read-only, чтобы запретить изменение данных и структуры БД
То есть отправили запрос к API через Postman, и здесь же проверили, что произошло с данными.
✅️️️️️️️ Наборы тестовых данных - Postman Datasets
БД можно подключить как источник данных и использовать её в:
▫️ Collection Runner
▫️ автотестах и скриптах
▫️ динамических Mock Server
▫️ нагрузочных тестах
▫️ Postman CLI и CI/CD-конвейерах
Большинство этих возможностей уже хорошо знакомо выпускникам нашей программы Дизайн REST API: мы работаем с коллекциями, переменными, скриптами, Mock Server.
Теперь к этому процессу можно подключить ещё и живые данные из PostgreSQL, MySQL или SQL Server.
📌️️ Как может выглядеть такой конвейер?
Допустим, мы тестируем создание заказа в интернет-магазине.
1️⃣ Postman получает из тестовой БД пользователей и товары, подходящие для сценария.
2️⃣ Collection Runner опираясь на реальные данные из БД по пользователям и товарам запускает:
POST /orders
3️⃣ Скрипт проверяет:
▫️ код 201 Created
▫️ структуру JSON
▫️ наличие orderId
▫️ правильность суммы и статуса
4️⃣ Затем Postman обращается к подключённой БД и проверяет:
SELECT status, total_amount, user_id
FROM orders
WHERE id = :orderId;
5️⃣ Сравниваем ответ API с тем, что реально сохранилось в таблице.
6️⃣ Эту же коллекцию можно автоматически запускать через Postman CLI в CI/CD после обновления приложения.
И вот здесь уже понятен смысл обновления.
Раньше тестовые данные часто жили в CSV-файлах, переменных окружения и локальных скриптах. На компьютере одного человека всё работало, а в автоматическом запуске внезапно ломалось, потому что файл забыли обновить или передать.
Теперь команда может использовать единый источник данных и воспроизводить одинаковые сценарии локально, в Collection Runner и в автоматическом конвейере.
🦫 DBeaver при этом всё ещё нужен.
В нём удобнее полноценно исследовать БД, проектировать структуру, работать с индексами, ограничениями, сложными запросами и администрированием.
🟧 Postman нужен для другого:
1. вызвали API
2. проверили ответ
3. проверили данные
4. запустили сценарий тестирования автоматически
👉 Чем это полезно системному аналитику?
Можно быстрее:
▫️ проверить маппинг полей API в таблицы БД
▫️ убедиться, что POST, PUT или PATCH действительно изменили данные
▫️ проверить статусы, связи и бизнес-ограничения
▫️ сравнить ответ API с фактическим состоянием БД
▫️ собрать воспроизводимый сценарий для разработчика или тестировщика
▫️ понять, где ошибка: в контракте API, бизнес-логике или сохранении данных
Особенно полезно, когда API вернул 200 OK, а в базе почему-то оказалось совсем не то, что ожидалось 😅
Подключаться лучше к тестовой БД, использовать отдельного пользователя с минимальными правами, включать Read-only, а пароли хранить в Postman Vault.
Получается, Postman постепенно превращается из клиента для HTTP-запросов в среду для проверки всего сценария работы бэкенда.
💡️️️️️️ А ваша команда использует Postman и знает про это обновление?
Будьте первопроходцем, просвятите ваших QA и backend-разработчиков 😉
#ResApiGa
Tg | ВК | Max
 Новый список